정적 세그먼트 트리
이 포스트에서는 세그먼트 트리에 대해 알아보려고 한다.
세그먼트 트리는 배열의 특정 구간에 대한 연산(구간 합, 최솟값, 최댓값 등)과 특정 원소의 값에 대한 갱신이 빈번하게 일어날 때 사용하는 이진 트리 기반 자료구조이다. 여기서는 자바 코드를 활용할 것이니, 자바에 익숙하지 않은 사람은 다른 블로그를 들리길 바란다.
일반적인 1차원 배열을 생각해 보자. 만약 이게 처음 만들어지고 업데이트가 이루어지지 않는 방식이고 특정 구간의 합만 질의하는 방식이라면, 1차원 누적합을 자체적으로 O(N)을 활용해 만들어 평생 활용(인덱스 3부터 60까지의 누적합을 구하라는 질의가 들어오는 경우 (60 인덱스 위치의 누적합) - (2 인덱스 위치의 누적합)을 통해 O(1)로 바로 해결 가능)하는 것이 효율적일 것이다.
그러나, 배열의 요소에 대해서 수정이 자주 일어난다면 어떻게 될까?
가령, 길이 N = 10,000인 배열이 있고, 그 요소들에 대해서 무작위로 십만 번의 수정이 일어난다면? 그때그때 새로 누적합 배열을 만들어 줘야 하기 때문에 100,000 * 10,000 = 1,000,000,000번, 즉 10억 번의 연산이 업데이트 하는 데에만 활용이 될 것이다. 그렇다면 기존 방식으로는 이런 경우에 대응하기가 곤란해진다. 이럴 때 쓰라고 있는 자료구조가 바로 세그먼트 트리이다.
구간합 세그먼트 트리 이미지 예시.
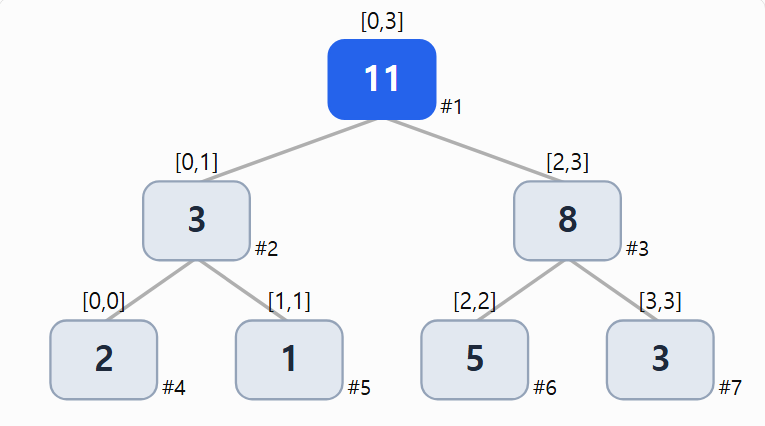
구간합 세그먼트 트리를 예로 들면 위의 그림과 같다. 원본 배열 arr이 따로 있을 때, 트리 배열 tree를 생성하여 각 노드마다 arr 배열의 start 인덱스부터 end 인덱스까지 범위를 담당하여 해당 구역의 누적합을 저장한다. 리프 노드는 해당 arr 배열의 값만 저장하고 있으며, 부모 노드는 담당하고 있는 리프 노드들의 값의 합을 저장한다.
세그먼트 트리에서는 크게 세가지의 메소드가 기본적으로 필요하다.
첫 번째로, 기존 배열 arr을 바탕으로 초기 세그먼트 트리 tree를 구축하는 함수 build().
두 번째로, tree를 구축한 상태에서 arr의 특정 index의 값을 value로 업데이트 하고자 할 때, tree를 그에 따라 수정해주는 update() 함수.
마지막으로, 현재 tree 상에서 특정 구간(left부터 right)의 누적합을 반환하는 query() 함수.
build()
Build의 실제 실행 순서
arr이 {2, 1, 5, 3}인 배열일 때, build(1, 0, 3)를 호출할 시 값이 저장되는 순서는 다음과 같다.
원리를 알았다면 이제 코드로 구현해보자. 각 함수의 세부 내용을 구현하기 전, 먼저 기본 구조를 만들어본다.
public class SegmentTree { static int[] arr = {2, 1, 5, 3}; static long[] tree = new long[arr.length * 4]; static void build(int node, int start, int end) { // TODO } static void update(int node, int start, int end, int index, int value) { // TODO } static long query(int node, int start, int end, int left, int right) { // TODO return 0; }}
여기에서 arr은 세그먼트 트리가 아니며, 기본적으로 주어지는 1차원 배열이다.
세그먼트 트리인 tree가 이 arr을 기반으로 누적합 자료구조를 관리하기 위해 따로 생성된다. tree 배열의 길이는 일반적으로 arr 길이의 4배로 설정하면 충분하다.
build() 함수는 다음과 같다.
static void build(int node, int start, int end) { // 1. 리프 노드에 도착한 경우 if (start == end) { tree[node] = arr[start]; return; } // 2. 리프 노드가 아닌 경우 // 2 - 1. 구간의 중간 지점 구하기 int mid = start + (end - start) / 2; // 2 - 2. 왼쪽과 오른쪽 자식 구축 build(node * 2, start, mid); build(node * 2 + 1, mid + 1, end); // 2 - 3. 자식의 결과를 합쳐 부모 노드 계산 tree[node] = tree[node * 2] + tree[node * 2 + 1];}
기본적으로 트리를 배열로 구현해 본 사람이라면, 자식 노드로 접근할 때 왼쪽 자식은 node * 2, 오른쪽 자식은 node * 2 + 1로 접근하면 된다는 것을 알 것이다.
세그먼트 트리에서 해당 노드가 책임지는 범위가 한 칸(start와 end가 동일)일 경우엔 해당 노드는 리프 노드가 되며, arr 배열의 해당 인덱스 값을 세그먼트 트리의 리프노드에 그대로 가져간다.
리프 노드가 아닐 경우에는 구간을 더 쪼개서 자식 노드들에 접근하여 같은 과정을 반복한다. 자식 노드들의 작업이 끝난 이후에는 해당 노드의 값을 자식 노드 값들의 합으로 지정한다.
update()
다음으로 update()의 코드를 알아보자. 업데이트를 하는 이 함수는 arr 배열에서 특정 인덱스 값의 변경이 일어날 때 세그먼트 트리 또한 같이 수정한다. 코드는 다음과 같다.
static void update(int node, int start, int end, int index, int value) { // 1. 현재 구간이 index를 포함하지 않으면 if (index < start || index > end) { return; } // 2. 리프 노드에 도착한 경우 if (start == end) { // tree와 arr 변경 tree[node] = arr[start] = value; return; } // 3. 리프 노드가 아닌 경우 // 3 - 1. 구간의 중간 지점 구하기 int mid = start + (end - start) / 2; // 3 - 2. 왼쪽 또는 오른쪽 자식으로 이동 if (index <= mid) { update(node * 2, start, mid, index, value); } else { update(node * 2 + 1, mid + 1, end, index, value); } // 3 - 3. 부모 노드의 합 다시 계산 tree[node] = tree[node * 2] + tree[node * 2 + 1];}
업데이트를 하는 경우엔 build()와 달리 모든 자식 노드에 방문할 필요가 없다. 따라서 if문으로 내가 업데이트 하려는 index가 속한 자식으로만 내려가면 된다.
그 이외엔 우리가 타깃하는 index의 범위에 대해 예외처리를 하는 것 말고는 build()와 크게 다르지 않다.
query()
마지막으로 query() 함수에 대해 알아보자. 이 함수는 원본 배열에서 특정 구간의 합을 묻는 함수이며, 우리가 지금껏 만든 세그먼트 트리를 활용한다.
static long query(int node, int start, int end, int left, int right) { // 1. 현재 구간과 조회 구간이 전혀 겹치지 않으면 if (left > end || right < start) { return 0; } // 2. 현재 구간이 조회 구간에 완전히 포함되면 if (left <= start && right >= end) { return tree[node]; } // 3. 일부만 겹치면 두 자식의 결과를 합산 int mid = start + (end - start) / 2; return query(node * 2, start, mid, left, right) + query(node * 2 + 1, mid + 1, end, left, right);}
이건 앞의 두 함수들과 좀 다르다. 이 함수는 크게 세가지를 고려하면 된다.
먼저 우리가 조회하려는 구간의 맨 왼쪽을 left, 맨 오른쪽을 right라고 해보자. 이때 조회를 하기 위해 노드를 내려가면서 어떤 노드 입장에선 본인이 담당하는 start부터 end까지의 구역이
left부터right까지의 구역과 전혀 겹치지 않을 경우left부터right까지의 구역과 일부만 겹칠 경우left부터right까지의 구역에 포함될 경우
가 있을 것이다.
그 세가지를 잘 고려해 주면, query()를 해결할 수 있다.
전체 코드는 아래와 같다. 테스트 코드까지 포함했으니 복사해서 실행해보면 되겠다.
public class SegmentTree { static int[] arr = {2, 1, 5, 3}; static long[] tree = new long[arr.length * 4]; static void build(int node, int start, int end) { // 1. 리프 노드에 도착했다면? if (start == end) { tree[node] = arr[start]; return; } // 2. 구간의 중간 지점 구하기 int mid = start + (end - start) / 2; // 3. 왼쪽과 오른쪽 자식 구축 build(node * 2, start, mid); build(node * 2 + 1, mid + 1, end); // 4. 자식의 결과를 합쳐 부모 노드 계산 tree[node] = tree[node * 2] + tree[node * 2 + 1]; } static void update(int node, int start, int end, int index, int value) { // 1. 현재 구간이 index를 포함하지 않으면 if (index < start || index > end) { return; } // 2. 리프 노드에 도착했다면 if (start == end) { // tree와 arr 변경 tree[node] = arr[start] = value; return; } int mid = start + (end - start) / 2; // 3. 왼쪽 또는 오른쪽 자식으로 이동 if (index <= mid) { update(node * 2, start, mid, index, value); } else { update(node * 2 + 1, mid + 1, end, index, value); } // 4. 부모 노드의 합 다시 계산 tree[node] = tree[node * 2] + tree[node * 2 + 1]; } static long query(int node, int start, int end, int left, int right) { // 1. 현재 구간과 조회 구간이 전혀 겹치지 않으면 if (left > end || right < start) { return 0; } // 2. 현재 구간이 조회 구간에 완전히 포함되면 if (left <= start && right >= end) { return tree[node]; } // 3. 일부만 겹치면 두 자식의 결과를 합산 int mid = start + (end - start) / 2; return query(node * 2, start, mid, left, right) + query(node * 2 + 1, mid + 1, end, left, right); } public static void main(String[] args) { build(1, 0, arr.length - 1); System.out.println(query(1, 0, 3, 1, 2)); // 6 update(1, 0, 3, 1, 10); System.out.println(query(1, 0, 3, 1, 2)); // 15 System.out.println(query(1, 0, 3, 0, 3)); // 20 }}
이제 세그먼트 트리에 대해 알아보았으니, 관련 문제를 풀어보자.
만약 조건이 0-based 인덱스, 1 ≤ N ≤ 100,000, 1 ≤ Q ≤ 100,000, 원소의 절댓값 ≤ 1,000,000,000이며
처음에 정수 배열 길이 N, Q개의 쿼리가 들어오고,
1 i x의 경우 인덱스 i의 값을 x로 변경,
2 l r의 경우 인덱스 l부터 r까지 합 출력을 하라는 의미인 경우,
5 52 1 5 3 42 1 31 2 102 1 32 0 42 2 2
와 같은 input이 들어오고
출력이
9142010
로 나와야 할 때, 아래와 같이 코드를 작성하면 된다.
import java.io.BufferedReader;import java.io.IOException;import java.io.InputStreamReader;import java.util.StringTokenizer;public class SegmentTree { static BufferedReader br = new BufferedReader(new InputStreamReader(System.in)); static StringBuilder output = new StringBuilder(); static StringTokenizer st; static int [] arr; static long [] tree; static int N, Q; static void build(int node, int start, int end) { if (start == end) { tree[node] = arr[start]; return; } int mid = start + (end - start) / 2; build(node * 2, start, mid); build(node * 2 + 1, mid + 1, end); tree[node] = tree[node * 2] + tree[node * 2 + 1]; } static void update(int node, int start, int end, int index, int value) { if (index < start || index > end) { return; } if (start == end) { tree[node] = arr[start] = value; return; } int mid = start + (end - start) / 2; if (index <= mid) { update(node * 2, start, mid, index, value); } else { update(node * 2 + 1, mid + 1, end, index, value); } tree[node] = tree[node * 2] + tree[node * 2 + 1]; } static long query(int node, int start, int end, int left, int right) { if (left > end || right < start) { return 0; } if (left <= start && right >= end) { return tree[node]; } int mid = start + (end - start) / 2; return query(node * 2, start, mid, left, right) + query(node * 2 + 1, mid + 1, end, left, right); } public static void main(String[] args) throws IOException { st = new StringTokenizer(br.readLine()); N = Integer.parseInt(st.nextToken()); Q = Integer.parseInt(st.nextToken()); arr = new int[N]; tree = new long[N * 4]; st = new StringTokenizer(br.readLine()); for (int i = 0; i < N; i++) { arr[i] = Integer.parseInt(st.nextToken()); } build(1, 0, N - 1); for (int i = 0; i < Q; i++) { st = new StringTokenizer(br.readLine()); if(Integer.parseInt(st.nextToken()) == 1) { update(1, 0, N - 1, Integer.parseInt(st.nextToken()), Integer.parseInt(st.nextToken())); } else { output.append(query(1, 0, N - 1, Integer.parseInt(st.nextToken()), Integer.parseInt(st.nextToken()))).append('\n'); } } System.out.println(output); }}
만약 이 구간합 세그먼트 트리에서 구간 최솟값 세그먼트 트리로 바꾸려면, 다음의 부분을 바꾸면 된다.
| 구간합 | 최솟값 | |
build() | tree[node] = tree[node * 2] + tree[node * 2 + 1]; | tree[node] = Math.min(tree[node * 2], tree[node * 2 + 1]); |
update() | tree[node] = tree[node * 2] + tree[node * 2 + 1]; | tree[node] = Math.min(tree[node * 2], tree[node * 2 + 1]); |
query() | if (left > end || right < start) { return 0; } | if (left > end || right < start) { return Integer.MAX_VALUE; } |
query() | return query(node * 2, start, mid, left, right) + query(node * 2 + 1, mid + 1, end, left, right); | return Math.min(query(node * 2, start, mid, left, right), query(node * 2 + 1, mid + 1, end, left, right)); |
세그먼트가 더 응용될 때는,
- 병합 연산(Merge): 두 자식 노드의 정보를 어떻게 합칠 것인가?
- 항등원(Identity): 결과에 영향을 주지 않는 값은 무엇인가?
이 두가지를 유의하면서 하면 풀 수 있다.
세그먼트 트리의 응용에는 크게 두 가지가 있는데, 다음과 같다.
| 구분 | 예시 | 학습 방향 |
|---|---|---|
| 기존 구조의 변형 | 최솟값, 최댓값, GCD, 최댓값 등장 횟수 | 필요할 때 직접 유도 |
| 구조 자체의 확장 | Lazy Propagation, Persistent Segment Tree | 별도로 원리 학습 필요 |
위의 표에서 기존 구조의 변형에 해당하는 것들의 경우, 원리만 잘 학습한다면 바로바로 응용이 가능하다. 하지만 구조 자체의 확장은 따로 학습이 필요하다.
그래서 나중 포스트에서는, 구조 자체의 확장에 해당하는 Segment Tree 응용을 알아보겠다.


답글 남기기